
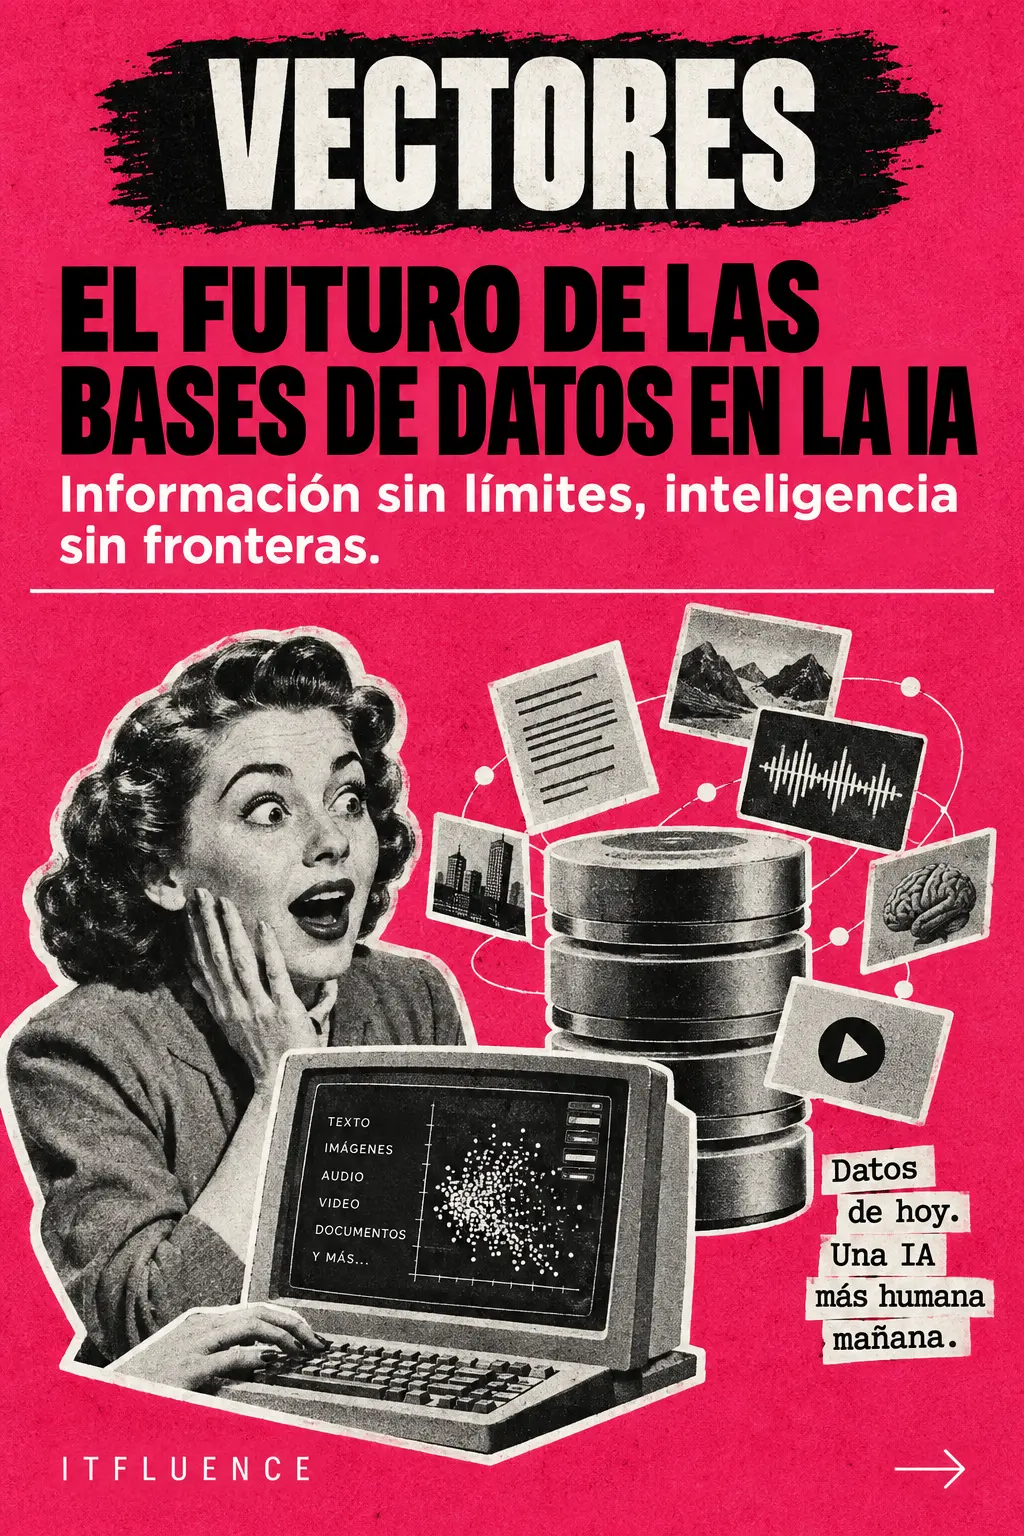
La revolución de las bases de datos vectoriales en la inteligencia artificial
Las aplicaciones de inteligencia artificial actuales están enfrentando un desafío crítico: procesar grandes volúmenes de información no estructurada. La incapacidad de los sistemas tradicionales para comprender el significado contextual del lenguaje humano ha llevado al desarrollo de bases de datos vectoriales como solución esencial. Estas bases de datos permiten que los modelos de lenguaje de gran tamaño (LLM) entreguen respuestas precisas utilizando arquitecturas de generación aumentada por recuperación (RAG).
A diferencia de las bases de datos relacionales convencionales que buscan coincidencias exactas de palabras, los motores vectoriales identifican conceptos relacionados en milisegundos. Esta capacidad evita respuestas erróneas de los chatbots, optimiza el límite del contexto y reduce costes operativos en entornos empresariales. Entender cómo trabajan las bases de datos vectoriales es clave para abordar el futuro de la IA.
En un sistema relacional típico, como SQL, los datos se organizan en filas y columnas con formatos estrictos. Sin embargo, para datos sin estructura fija, las bases de datos vectoriales almacenan información junto con sus vectores representativos. Un vector es una secuencia numérica fija generada por un modelo de incrustación o embedding, analizando el contenido y asignándole coordenadas en un espacio multidimensional.
El uso de la misma red neuronal para almacenar y consultar datos permite que, al buscar «animales domésticos oscuros», el sistema identifique fotografías de gatos negros aunque la palabra «gato» no esté presente. Esta funcionalidad es vital para enfrentar limitaciones técnicas de arquitecturas tradicionales.
Los grandes modelos de lenguaje han señalado problemas como el filtrado semántico, donde las búsquedas literales no recuperan la información adecuada. Además, el límite de contexto de entrada, frecuentemente alcanzando 128,000 tokens, es costoso. Las bases de datos vectoriales seleccionan solo los fragmentos más relevantes antes de enviarlos al modelo.
La integración en RAG ofrece ventajas, reduciendo significativamente las alucinaciones de inteligencia artificial al nutrir las respuestas con fuentes verificadas. Existen motores vectoriales como Pinecone, Qdrant, Weaviate, y sistemas como Milvus o Chroma para diferentes necesidades y prototipos.
Extensiones como PGVector para PostgreSQL o módulos vectoriales en Elasticsearch y MongoDB Atlas añaden capacidad semántica sin necesidad de servidores independientes. Implementarlas presenta desafíos, como el chunking del texto y la reindexación si se cambia el modelo de incrustación.
Las bases de datos vectoriales marcan un paso hacia sistemas que comprenden la información. La convergencia con motores relacionales clásicos será la tendencia futura. Sin embargo, para aplicaciones pequeñas o consultas numéricas, las bases de datos tradicionales siguen siendo más eficientes. En proyectos de análisis documental o asistentes virtuales, la lógica vectorial es indispensable.